


Programação geral
PALESTRAS
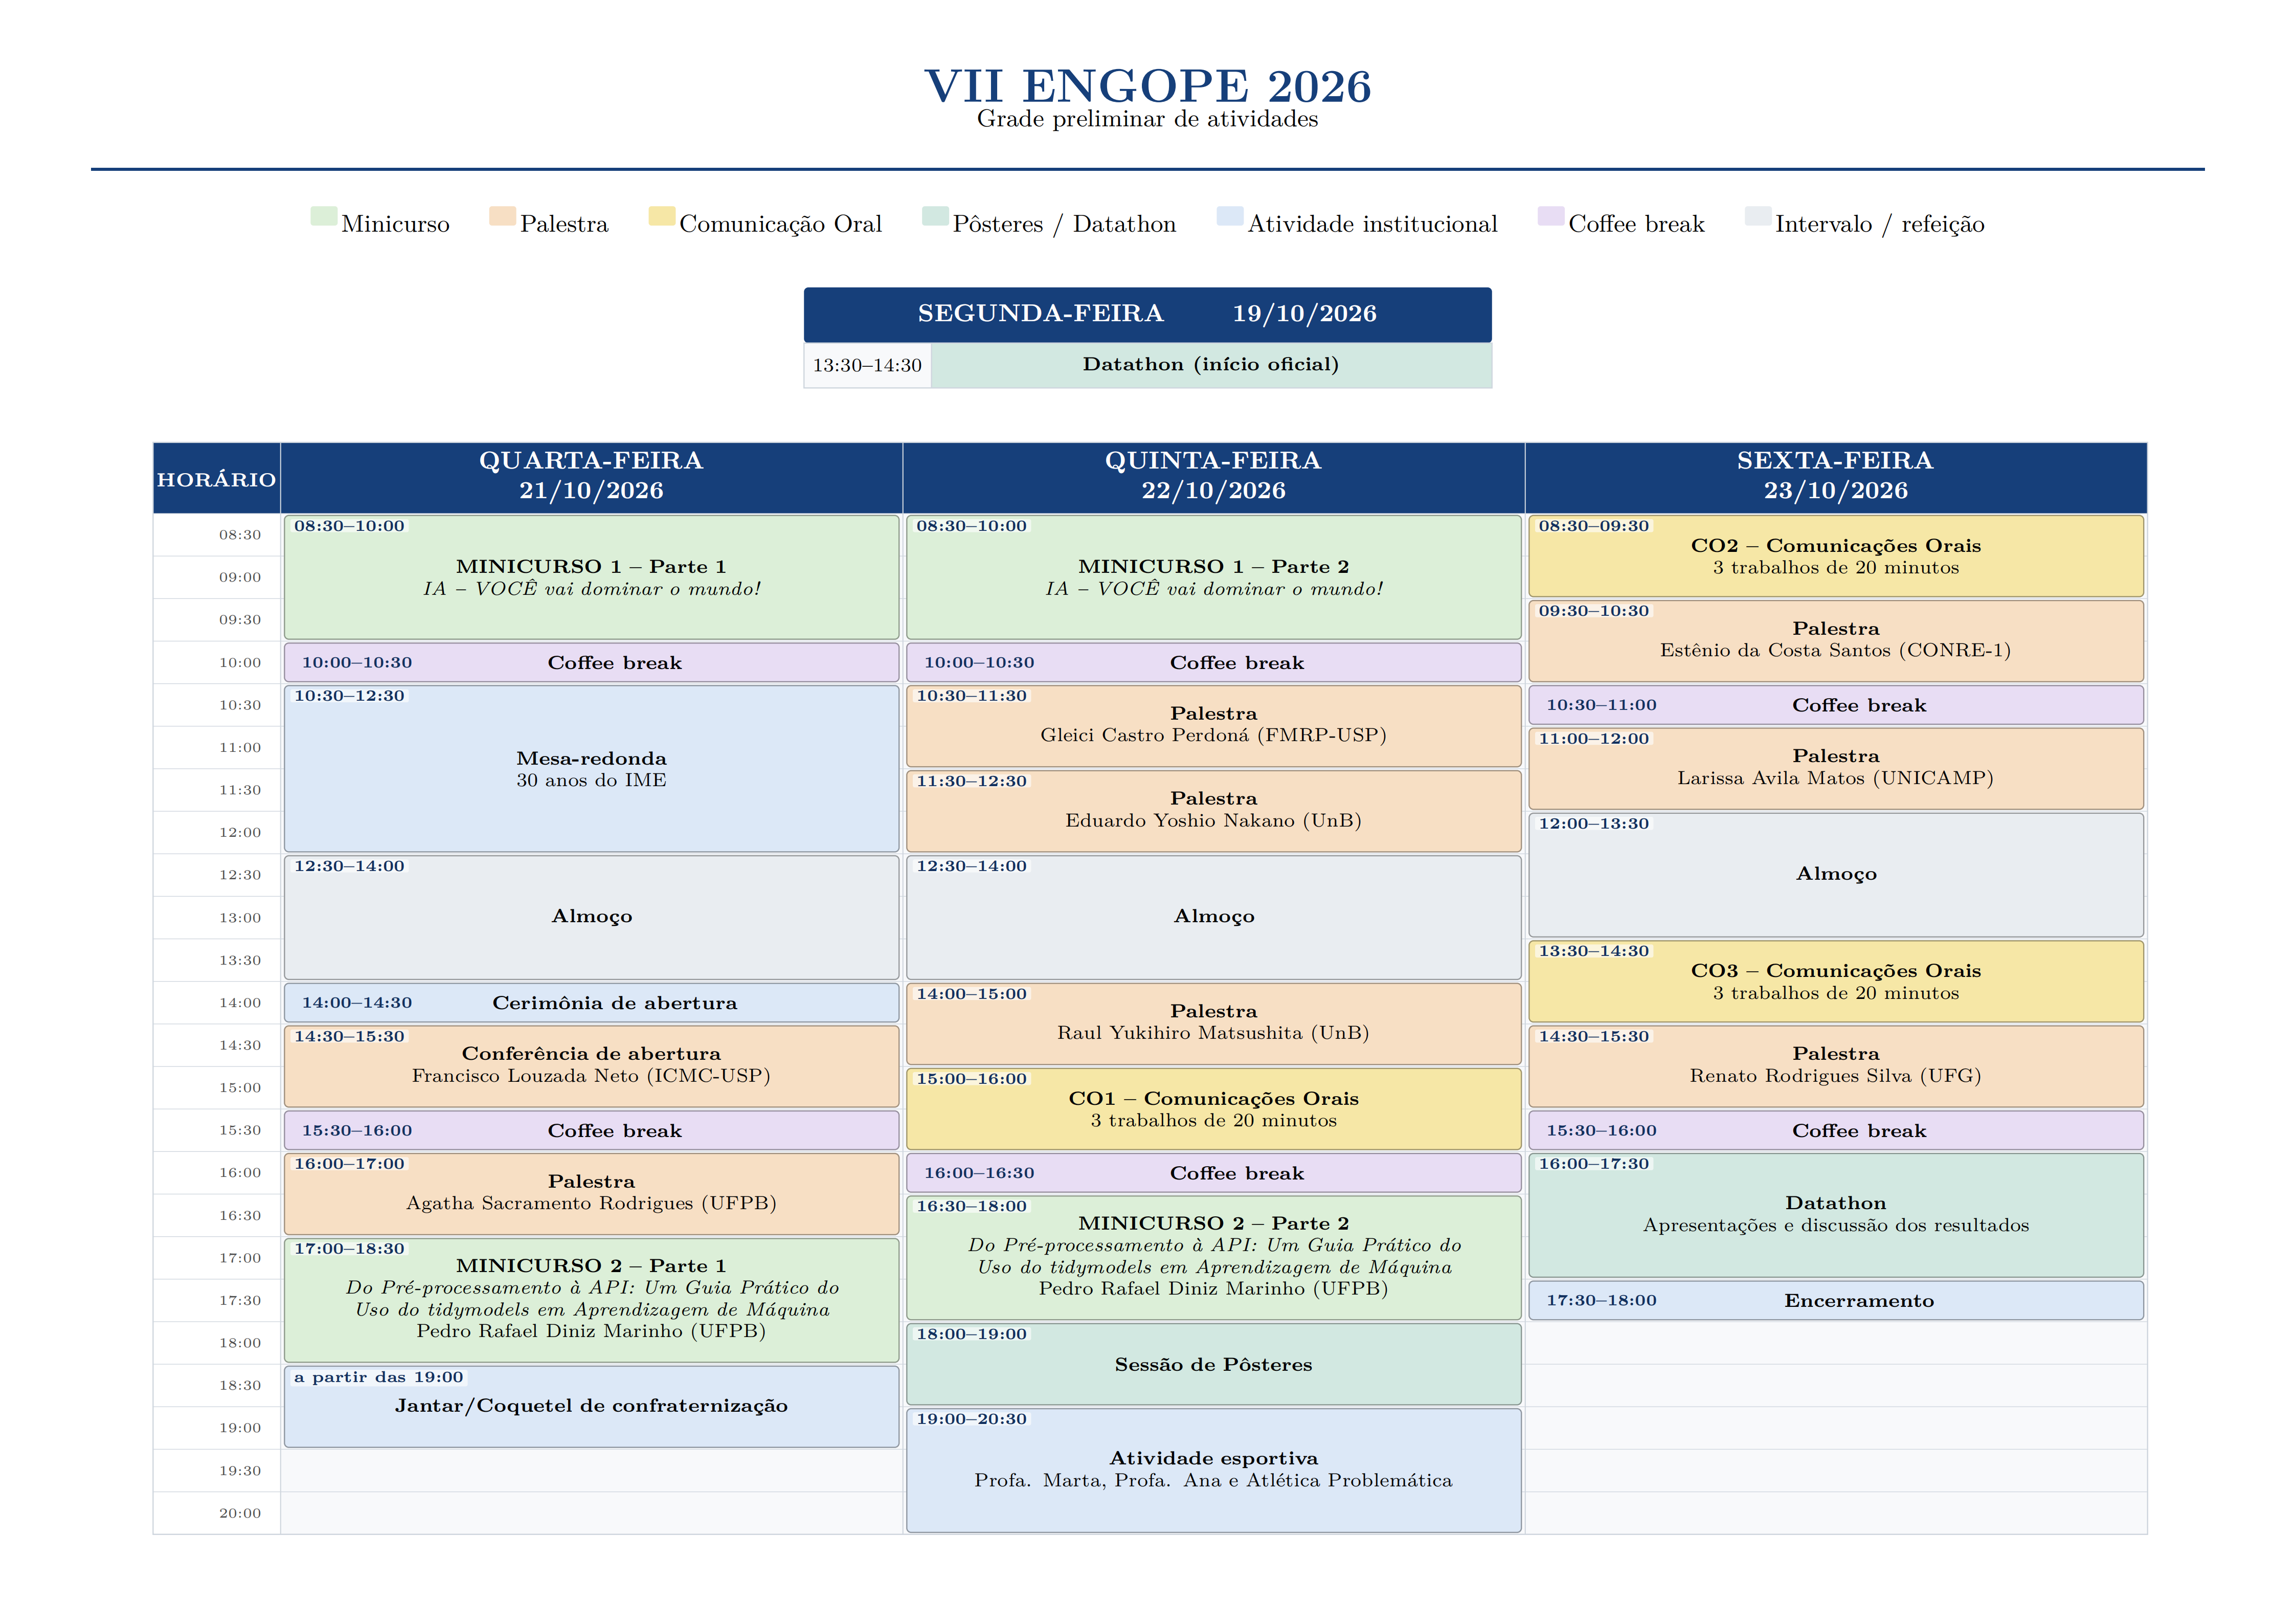
Data: 21/10/2026 (Quarta-feira)
- Palestrante: Francisco Louzada Neto (CeMEAI-ICMC-USP)
Título: Liderança Científica na Era da IA.
Horário: 14:30
Resumo: A ascensão da IA colocou a Estatística diante de uma escolha: permanecer disciplina de apoio ou assumir a liderança científica da revolução de dados. Liderar exige profundidade estatística, pensamento computacional e diálogo interdisciplinar. Tomando o CeMEAI, centro da USP, como estudo de caso, mostramos que essa liderança se sustenta em infraestrutura, formação em escala e pontes com o setor produtivo, que transformam método em produto, decisão e impacto, ilustrados por casos como confiabilidade de equipamentos de perfuração de petróleo, detecção de fraude financeira e comunicação em redes móveis. Finalizamos com três desafios: formar em escala com equidade, internacionalizar sem esvaziar e posicionar a Estatística e a Ciência de Dados no centro da IA.
- Palestrante: Agatha Sacramento Rodrigues (UFPB)
Título: Políticas públicas orientadas por dados para a população materna: a experiência do Observatório Obstétrico Brasileiro (OOBr)
Horário: 16:00
Resumo: O Brasil tem uma das bases públicas de saúde mais ricas do mundo. Ainda assim, as informações sobre saúde materna e perinatal raramente chegam a gestores e à sociedade de forma rápida, interpretável e comparável entre territórios. O Observatório Obstétrico Brasileiro (OOBr) foi criado para ocupar esse espaço. É uma plataforma interativa, aberta e reprodutível, que monitora, analisa e divulga dados públicos de saúde, socioeconômicos e ambientais sobre a população materno-infantil. Nesta palestra, apresentamos a trajetória do OOBr e o que ela ensina sobre o papel da Estatística na formulação de políticas públicas. Durante a pandemia de COVID-19, o monitoramento contínuo das gestantes e puérperas hospitalizadas, divulgado em painéis interativos, subsidiou a inclusão dessa população no grupo prioritário para vacinação. Esse trabalho foi citado pela Organização Mundial da Saúde e originou uma publicação em parceria com o UNFPA. Mais recentemente, o projeto foi finalista do Digital@UNGA Awards 2026 (ITU/ONU). Depois da emergência sanitária, o OOBr voltou-se para a redução da mortalidade materna, fetal e neonatal. Um exemplo é o SIGMATER, ferramenta de apoio à decisão que combina o risco de desfechos maternos graves por causa com a capacidade resolutiva hospitalar para recomendar o encaminhamento das pacientes, com piloto na Paraíba e no Piauí. Outro é o ReMaP, desenvolvido em parceria com a Secretaria de Estado da Saúde de São Paulo para reestruturar a rede de atenção materna e perinatal. Como estudo de caso, apresentamos um modelo bayesiano de riscos competitivos para o tempo até o parto, com efeito espacial ICAR no nível das Redes Regionais de Atenção à Saúde. O modelo trata o óbito fetal e o nascido vivo como desfechos concorrentes do mesmo processo gestacional. Ele revela forte heterogeneidade territorial e uma associação inversa entre a vulnerabilidade ao óbito fetal e o IDH regional, o que gera estimativas regionais com incerteza quantificada para orientar a priorização de regiões no SUS. Por fim, discutimos os desafios e as lições de transformar dados públicos em evidência útil para a gestão em saúde.
Data: 22/10/2026 (Quinta-feira)
- Palestrante: Gleici da Silva Castro Perdoná (FMRP-USP)
Título: Da Construção à Aplicação de um Modelo de Sobrevivência em Dados Obstétricos
Horário: 10:30
Resumo: A análise de sobrevivência reúne métodos estatísticos destinados ao estudo do tempo até a ocorrência de um evento. Nesta apresentação, será discutido o processo de construção de um modelo de sobrevivência aplicado ao tempo transcorrido entre a admissão hospitalar e o parto vaginal. Os dados são provenientes do projeto Better Outcomes in Labour Difficulty(BOLD), coordenado pela Organização Mundial da Saúde e realizado em hospitais da Nigéria e de Uganda, África. A estrutura dos dados apresenta desafios que não são contemplados simultaneamente pelos modelos usuais: observações com tempo igual a zero, tempos positivos eventualmente censurados e uma parcela de mulheres que não apresenta parto vaginal durante o acompanhamento. Para representar esses diferentes mecanismos, será apresentado o modelo de regressão Gama Generalizada com inflação de zeros e fração de cura (GG-ZICR). A distribuição Gama Generalizada descreve os tempos positivos e inclui, como casos particulares, distribuições conhecidas, como Weibull, Gama e Log-Normal. O modelo também permite associar covariáveis aos parâmetros da distribuição, à probabilidade de tempo zero e à fração de cura. A estimação é realizada pelo método de máxima verossimilhança. Um estudo de simulação mostra que o viés e o erro das estimativas diminuem com o aumento do tamanho amostral, embora alguns parâmetros necessitem de amostras maiores para alcançar maior estabilidade. Na aplicação a 7.062 mulheres, foram estimadas proporções de 4,5% para a massa no zero e de 4,0% para a fração sem parto vaginal durante o seguimento. A apresentação enfatiza, de forma didática, como a compreensão do processo gerador dos dados orienta a definição do evento, da censura e da estrutura probabilística mais adequada.
- Palestrante: Eduardo Yoshio Nakano (UnB)
Título: Um teste bayesiano para verificar a inexistência de casos em uma população finita
Horário: 11:30
Resumo: Um problema fundamental em estatística aplicada é o processo de estimação de uma proporção de uma característica de interesse em uma população finita. E é comum situações em que o evento de interesse é raro ou até mesmo inexistente. Nestas situações, o interesse pode ser justamente testar a hipótese de ausência dessa característica nessa população, como por exemplo verificar se uma comunidade está isenta de casos de COVID, se um lote de peças não apresenta itens defeituosos, etc. Se todos os indivíduos dessa população forem avaliados então é possível afirmar com certeza que essa característica está ausente ou presente nessa população. No entanto, nem sempre é possível avaliar todos os indivíduos de uma população devido a limitações de tempo e/ou orçamento. Ao considerarmos uma amostra, uma situação de incerteza pode ocorrer e o desafio será mensurar esse grau de incerteza. Para se ter uma ideia inicial do desafio que um estatístico (clássico) enfrenta nessa situação, basta perceber que ele somente poderá afirmar que característica de interesse é ausente caso não sejam observados quaisquer acontecimentos na amostra, ou seja, quando a variabilidade amostral é nula. Diante do exposto, esse seminário visa apresentar um teste bayesiano para verificar a ausência de casos em uma população finita. O teste é baseado em um procedimento simples e intuitivo e também permite definir o tamanho mínimo da amostra para garantir um pré-determinado nível de credibilidade na afirmação da hipótese de interesse.
- Palestrante: Raul Yukihiro Matsushita (UnB)
Título: Estimação não paramétrica da entropia diferencial: kernels de cauda pesada e aplicações a dados financeiros
Horário: 14:00
Resumo: A entropia diferencial constitui uma medida de incerteza para variáveis aleatórias contínuas e possui aplicações em diferentes áreas da Estatística, incluindo a análise de séries temporais e dados financeiros. Entretanto, sua estimação não paramétrica pode ser particularmente sensível ao comportamento das caudas da distribuição subjacente. Em especial, estimadores baseados em densidades kernel podem apresentar dificuldades quando aplicados a distribuições de caudas pesadas, característica frequentemente observada em retornos financeiros. Neste trabalho, discutimos a estimação não paramétrica da entropia diferencial por meio de funções kernel e propomos a utilização de um kernel de Pareto, cujo expoente é incorporado como um parâmetro adicional de suavização. Essa parametrização permite que o próprio procedimento de estimação se adapte ao comportamento das caudas dos dados, abrangendo desde kernels de cauda pesada até situações progressivamente mais concentradas. Os parâmetros de suavização são determinados por um critério de validação cruzada associado à perda de Kullback–Leibler. O desempenho do estimador é investigado por meio de experimentos de Monte Carlo envolvendo distribuições com diferentes graus de peso nas caudas e comparado a métodos alternativos de estimação da entropia diferencial. Os resultados evidenciam a importância da compatibilidade entre o comportamento das caudas da distribuição e da função kernel e mostram que o kernel de Pareto apresenta desempenho competitivo em termos de erro quadrático médio, viés e variância. Como ilustração, a metodologia é aplicada a séries de retornos financeiros, nas quais a estimação local da entropia e dos parâmetros do kernel permite caracterizar alterações na estrutura probabilística dos dados e identificar diferentes regimes estocásticos. A análise também indica que peso das caudas, volatilidade e incerteza representam características distintas da distribuição, reforçando a utilidade da entropia diferencial como ferramenta complementar para a análise de dados financeiros.
Data: 23/10/2026 (Sexta-feira)
- Palestrante: Estênio da Costa Santos (CONRE-1)
Título: Estatística e Ciência de Dados: o mercado de trabalho para as "duas" profissões.
Horário: 09:30
- Palestrante: Larissa Avila Matos (UNICAMP)
Título: Explorando Modelos Lineares Mistos: Uma Abordagem Robusta para Análise de Dados Longitudinais
Horário: 11:00
Resumo: Dados longitudinais são comumente analisados por meio de modelos lineares mistos que, por conveniência matemática, geralmente assumem distribuições normais tanto para os efeitos aleatórios quanto para os erros. No entanto, essas suposições restritivas podem resultar em falta de robustez frente a desvios da normalidade e em inferências estatísticas inválidas. Schumacher et al. (2021) propuseram uma extensão flexível dos modelos lineares mistos normais baseada na classe de distribuições mistura de escala da skew-normal, permitindo acomodar assimetria e caudas pesadas. Essa formulação também permite incorporar diferentes estruturas de dependência serial para representar a correlação intraindivíduo presente em dados longitudinais. Nesta palestra, apresentarei o pacote skewlmm do R e suas recentes atualizações. O pacote implementa a metodologia proposta por Schumacher et al. (2021) e oferece ferramentas para o ajuste e a avaliação de modelos lineares mistos robustos, incluindo comparação e seleção de modelos, análise de resíduos e recursos gráficos. Por meio de uma aplicação a dados longitudinais, serão exploradas as principais funcionalidades do pacote e discutidas estratégias para a construção e avaliação desses modelos na prática.
- Palestrante: Renato Rodrigues Silva (UFG)
Título: Da correlação à causalidade: uma análise da evolução do pensamento estatístico
Horário: 14:30
Resumo: A relação entre correlação e causalidade atravessa a história da estatística e ainda define o que se pode concluir de dados observacionais. Este trabalho traça a evolução do pensamento estatístico, da formalização da correlação até a inferência causal contemporânea. Parte-se de Francis Galton, que, ao estudar a estatura de pais e filhos, descreveu a regressão à média e associou a herdabilidade a uma visão determinista de natureza versus criação, vinculada ao movimento eugenista. Em seguida, Karl Pearson deu rigor matemático ao coeficiente de correlação, mas adotou uma epistemologia positivista que tratava a causalidade como mero caso limite de correlação perfeita. George Udny Yule levou a regressão múltipla às ciências sociais ao analisar a Lei dos Pobres inglesa, e seu uso de controles estatísticos para atribuir efeito causal à política de assistência é discutido à luz de críticas modernas, como a causalidade reversa e a falácia ecológica. Sewall Wright, com a análise de trilha, introduziu diagramas e equações estruturais capazes de decompor correlações em efeitos diretos e indiretos, antecipando a modelagem causal. Por fim, o arcabouço de Judea Pearl distingue conceitos associacionais, definidos pela distribuição conjunta dos dados, de conceitos causais, que exigem premissas não testáveis sobre o processo gerador, expressas por grafos acíclicos dirigidos e pelo operador do(x). Como ilustração, o paradoxo de Simpson é analisado em um modelo linear com confundidor, mostrando que o coeficiente de regressão simples soma o efeito direto da variável explicativa ao desfecho a um componente não causal, e que o coeficiente de regressão parcial padronizado recupera o efeito direto quando o confundimento é corretamente especificado. Conclui-se que a transição da correlação à causalidade depende não de técnicas estatísticas isoladas, mas de pressupostos causais explícitos e de diagramas que os tornem discutíveis.